분류 모델의 평가 지표 알아보기
들어가기 앞서…
이 내용을 이해하기 위해서는 중학교 수준의 수학 능력 가지면 됩니다!
분류 문제를 푸는 원리
대부분의 일반 사람들이 머신러닝 기법 등의 예측 AI를 통해 가지고 싶은 것은 구별 능력입니다. 이 데이터를 가지고 있는 사람들이 이번 달에 구매할까? 이런 RGB 정보를 가지고 있는 사진이 고양이일까? 이러한 구별을 하기 위해서 머신러닝을 사용하여 분류기, classifier를 만들려고 합니다. 그러나, 사실은 머신러닝은 데이터를 구별해주지 않습니다. 각 데이터별로 어떤 분류일지 “확률”을 추정해줍니다. 특히, 우리가 예측하고자 하는 값이 어떤 특성으로 분류되는지가 아니라, 이 데이터가 어떤 클래스에 들어갈지 말지에 대한 binary 변수라면, classifier는 클래스에 들어갈 확률을 추정해줍니다. 그렇다면 이 상황에서 어느 정도 확률이 높으면 1이고, 그게 아니면 0이라고 정의할 수 있을텐데, 어떤 threshold를 기준으로 추정을 해야할지 감이 안올 수 있습니다. 수량을 예측하는 regression의 경우에는 간단하게 MSE(Mean Squared Error)나 MAE(Mean Absolute Error)를 통해 모델의 예측력을 평가할 수 있지만, binary classification에서는 threshold를 2차적으로 계산을 해야하기 때문에 예측력을 측정하기 다소 애매합니다. 그렇다면, 이 threshold를 어떻게 정의하면 좋을까요?
만약 우리가 threshold $(th)$ 를 임의로 정했다고 합시다. 그러면 우리의 예측치 $P_i > th$이면 1, $P_i \leq th$이면 0으로 정의를 해봅시다. 즉,
\[\hat{Y}_i=\begin{cases}1 &\text{if }P_i > th\\ 0 &\text{if }P_i \leq th\end{cases}\]인 상황입니다. 그러면 당연히 $\hat{Y}_i \in {0, 1}$입니다. 이 상황에서 우리는 true Y값인 $Y_i$와 predicted Y값인 $\hat{Y}_i$가 존재합니다. 이렇게 이진 분류에 대한 예측치와 실제 값이 있을 때, 분류 예측력을 평가할 수 있는 좋은 메트릭 $Metric(Y, \hat{Y}; th)$가 있다고 했을 때, threshold는 다음과 같이 세팅할 수 있습니다.
\[th = \operatorname{argmax}_k Metric(Y, \hat{Y}; k)\]여기서 어떤 분류 metric을 사용하면 좋을까요? 이는 상황, 데이터마다 다르겠지만, 일반적으로 쓰이는 것들을 한 번 의미를 짚어가며 보도록 하겠습니다. 이번 포스팅에서 저희가 볼 것은 다음 4가지입니다.
- Accuracy
- Precision
- Recall
- F1 Score
네가지 metric 모두 $\hat{Y}_i$와 $Y_i$를 인풋으로 해서 나오는 0과 1 사이의 값이며, 1로 가면 갈 수록 예측력이 좋다고 보통 이야기 할 수 있습니다. 그렇다면 각각에 대해서 살펴보도록 하겠습니다.
Accuracy - 가장 intuitive한 metric
우리가 생각했을 때, 예측을 가장 잘했다는 것은 바로 $\hat{Y}_i = Y_i$인 $i$의 값들이 많다는 것입니다. 다른 말로 하면, 예측치와 실제치가 같은 데이터의 비율이 많을 수록 예측을 잘했다고 할 수 있는 것이죠. 이 정신으로 나온 metric이 accuracy입니다. 수식적으로 표현하자면,
\[\operatorname{Acc}(Y, \hat{Y}) = \frac{\sum_i\mathbf{1}(Y_i = \hat{Y}_i)}{\#i}\]가 됩니다. 이런 accuracy가 항상 높으면 좋겠지만, 실제로는 이렇게 accuracy가 항상 1로 가지는 않습니다. 대부분 데이터 분석 및 예측 모델을 만들었을 때 accuracy는 0.9 혹은 그 아래일 것입니다. 그러면 이 때 다음과 같은 고민을 자연스럽게 할 수 있습니다. “accuracy 올리는건 포기!, 같은 accuracy라 하더라도 어떤 모델이 더 성능이 좋다고 말할 수 있을까?” 이 문제를 해결하기 위해 등장한 것인 Recall과 Precision입니다.
Recall & Precision - 필요한 상황만 발라내서 확인하자
Accuracy 메트릭이 만들어진 기저는 “예측치와 실제값이 같은지 여부에 대해 관심”입니다. 그러나, 사실 예측치와 실제값을 잘 뜯어보면 다음과 같은 2가지의 경우가 각각 존재함을 확인할 수 있습니다.
- 예측치가 1인지 0인지
- 실제값이 1인지 0인지
따라서, 이들을 2차원 평면에 잘 나타내보면 2x2 = 4가지의 경우의수가 나오는 것을 확인할 수 있습니다
- 예측치가 1인데 실제값이 1인경우 (True Positive; TP)
- 예측치가 0인데 실제값이 1인경우 (False Negative; FN)
- 예측치가 1인데 실제값이 0인경우 (False Positive; FP)
- 예측치가 0인데 실제값이 0인경우 (True Negative; TN)
이 중 (1)과 (4)번은 예측치와 실제값이 같기 때문에 True, (2)와 (3)번은 다르기 때문에 False로 정의합니다. 다만 예측치와 실제값이 같은 경우에 의해서 동일한 것이 아니기 때문에, 각각에 대해서 또다른 네이밍이 필요합니다. 예를 들어 (1)번은 Positive로 예측했는데 실제로도 Positive이니 True Positive, (2)번은 Negative로 예측했는데 실제로는 Positive이니 False Negative, … 이런식으로 말이죠.
이를 그림으로 나타내면 다음과 같습니다.
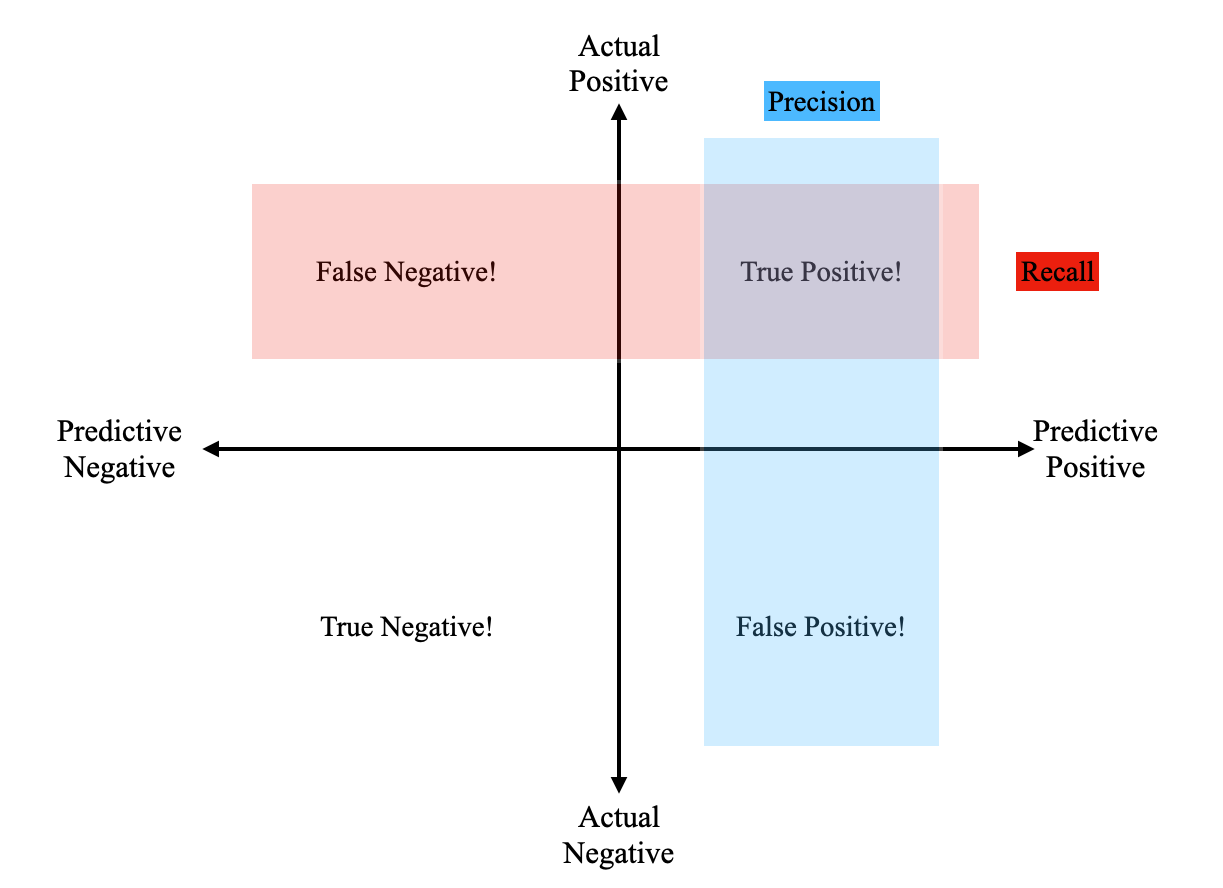
Fig.1 Predict - Actual Mapping
이렇게 좌표평면으로 나타내면 어떤게 좋을까요? 저희는 accuracy를 여러 컴포넌트로 분리할 수 있는 새로운 관점을 얻게 됩니다. 기존의 accuracy를 계산하는 식은 다음과 같았습니다.
\[\operatorname{Acc}(Y, \hat{Y})=\frac{\sum_i\mathbf{1}(i\in TP \cup TN)}{\#i}\]그러나 이는 우리가 관심 밖에 있는 영역도 수식에 반영되는 결과가 나옵니다. 때로는, 전체 accuracy를 보는 것 뿐 아니라 이 “모델의 Positive 예측이 얼마나 진짜인지”, 혹은 “실제 Positive를 얼마나 잘 맞추는지” 등에 대해서 더욱 관심이 있을 수 있습니다.
타겟 마케팅을 하는 경우를 예를 들어서 생각해보겠습니다. 마케터들은 최대한 구매를 많이 할 것 같은 사람들을 예측해서 해당 고객을 대상으로 타겟을 해야합니다. 이 때 머신러닝 모델을 사용한다고 할때 단순히 accuracy를 보는 것은 큰 도움이 되지 않습니다. 다만 “실제 구매할 사람 중에 모델이 예측한 구매자 수의 비율”을 보는 것이 모델을 선택할 때 더 큰 도움이 되겠죠. 이런 경우처럼 “실제 positive중 true positive의 비율”을 자주 접할 수 있는데, 이는 특히 Precision이라는 이름의 metric으로 정의됩니다.
이번엔 약물을 투여하는 경우를 예를 들어 생각해보겠습니다. 의사는 특정한 병이 의심되는 환자에게 약을 투여해야합니다. 다만 이 약은 위력이 세기 때문에 실제로 병이 없는 사람들에게 투여하기엔 꽤나 위험한 약입니다. 똑같이, 머신러닝 모델을 사용해서 예측을 한다고 할 때 accuracy를 보는 것은 큰 도움이 되지 않습니다. 대신 “병이 있다고 예측한 사람 중 실제로 병이 있는 사람의 비율”을 보는 것이 모델을 선택할 때 더 좋은 의사결정을 내릴 수 있을 것입니다. 이런 경우처럼 “예측 positive중 true positive의 비율” 역시 자주 접할 수 있는 예시인데, 이는 Recall이라는 이름의 metric으로 정의됩니다.
다만 여기서 주의깊게 봐야하는 것은, False Positive가 아무데도 반영되지 않았다는 점입니다. 이 이유는 뭘까요? 일반적으로, 저희가 0 / 1로 예측하는 것 자체는 의미가 없습니다. 왜냐면 어떠한 모델 $F$가 0을 예측하는 것은 또다른 모델 $1-F$가 1을 예측하는 것과 동일하기 때문에, 우리는 0과 1이라는 숫자 자체로 접근하지 않습니다. 다만 0과 1에 대해 정성적인 의미를 추후에 부여할 뿐입니다. 사람들은 직관적으로 더 중요한 행위를 완수한 경우에 1로, 그 외에 0으로 코딩하여 모델을 학습시키기 때문에, False Positive는 태생적으로 크게 중요한 변수가 아님을 알 수 있는 것이죠. 만약 FP가 TP보다 더 중요하다면, 그대로 0과 1을 스위칭해서 precision 및 recall을 계산하시면 됩니다.
다만, 여기서도 문제가 생깁니다. Precision과 Recall 중 하나의 metric만 보기 애매한 경우가 있을 수 있습니다. 타겟 마케팅과 약물 투여와 같은 극단적인 상황이 아니고서야, 우리는 precision과 recall 중 하나를 취사선택해서 모델 선정 metric으로 잡기 애매합니다. 이를 보완하기 위해 다음과 같은 metric이 등장하게 됩니다.
F1 Score - Combination of Recall and Precision
우리는 precision과 recall 둘 다 한 번에 고려하기 어렵다는 걸 인지했습니다. 그렇다면 이를 어떻게 해결하면 좋을까요? 가장 간단한 방법은, 바보 덧셈을 해보는겁니다.
바보 덧셈이란, 분수 계산에서 단순히 분자와 분모를 각각 더하는 것을 의미합니다.
\[\frac{a}{b}+\frac{d}{c}\Rightarrow \frac{a+d}{b+c}\]당연히 LHS와 RHS는 등호가 아니기에 Rightarrow로 표기를 했습니다. 바보 덧셈을 했을 때의 가장 큰 장점은 a/b, d/c가 0~1 사이인 경우 바보 덧셈의 결과도 마찬가지로 0~1의 사이에 있다는 점입니다. 이의 직관을 얻어, Precision과 Recall을 바보 덧셈을 해보도록 하곘습니다.
\[\operatorname{Prec}(Y, \hat{Y})+\operatorname{Rec}(Y, \hat{Y})\Rightarrow \frac{2TP}{2TP+FP+FN}\]이를 조금 더 간단하게 바꿔보겠습니다.
\[\begin{align*} \frac{2TP}{2TP+TN+FN}&=\frac{2}{\frac{TP+FN}{TP}+\frac{TP+FP}{TP}}\\ &=\frac{2}{\frac{1}{\frac{TP}{TP+FN}}+\frac{1}{\frac{TP}{TP+FP}}}\\ &=\frac{2}{\frac{1}{\operatorname{Rec}(Y, \hat{Y})}+\frac{1}{\operatorname{Prec}(Y, \hat{Y})}} \end{align*}\]어…? 저희는 분명히 바보 덧셈과 같은 이상한 짓거리를 했는데, 최종적으로는 Recall과 Precision의 조화평균으로 귀결되는 모습을 볼 수 있습니다. 이렇게 특이하게 생긴 metric을 우리는 F1 Score라고 정의하게 됩니다.
그러면 다시 돌아와서, 우리는 왜 F1 Score를 사용할까요? F1 Score를 쓰는 이유는 분모에 수정을 가하기 위해서입니다. 분모에 True Negative와 False Negative가 동시에 있는 형태라면, Recall과 Precision을 적절히 조합했다고 볼 수 있을 것 같습니다. 그러면 이를 어떻게 자연스럽게 동시에 만들 수 있을까요? 바보 덧셈을 통해서 자연스럽게(?) 만들었더니, 이게 알고보니 조화평균이었던 것이죠. 이를 사용하면 0~1사이의 숫자는 변하지 않는 대신, Recall과 Precision을 적절하게 배합했다고 볼 수 있을 것 같습니다.
결론
이번 포스팅을 통해서 우리는 분류 모델에 대한 평가 지표 및 발생 원리에 대해 간단하게 살펴봤습니다. 사실 수식 자체는 그렇게 어려운 편도 아니고, 다른 포스팅에 비해서 수학적인 선수 지식이 많이 요구되지도 않아서 특별한걸 원했던 분들에게는 살짝 실망했을 수도 있을 것 같습니다.
사실 이번 포스팅을 하게 된 계기는, 나름 Machine Learning 및 Econometric쪽을 다루는 블로그인데도 불구하고 평가지표 관련 포스팅이 하나도 없다면 다른 사람들이 보기에 “얘 가라 아니냐?”하는 의문을 가질 수도 있을 것 같아 최대한 제 나름대로 해석한 분류모델 평가지표에 대해 설명을 해봤습니다.
이번 포스팅에서 나열한 분류 지표를 다시 보자면 Accuracy, Precision, Recall, F1 Score입니다. 이 metric의 공통점은, 우리가 모형의 결과가 확률로 나오는데도 불구하고 이를 이산화(discretization)을 한 뒤에 계산할 수 있는 metric이라는 것입니다. 이렇게 특정 threshold를 기준으로 잘라서 해당 metric을 구성하는 것도 좋지만, 여기에는 가장 큰 문제가 있습니다. 바로 “모형과 threshold” 둘 다 optimization 해야한다는 뜻입니다. 이를 다르게 말하면, 모델 선정의 optimization cost가 너무 커지는 문제가 생깁니다. 따라서 해당 metric이 해석에는 용이하나 모델 선정 지표로 바로 사용하기에는 부적합할 수 있습니다.
그렇다면 이 문제를 어떻게 해결할 수 있을까요? 바로 probability 자체를 기반으로 성능을 계산하는 metric을 구성하는 것입니다. 다만 이렇게 가는 경우 우리는 알아야하는게 더 많아집니다. “확률”이란 무엇일까요? 우리는 “확률”을 관측할 수 있을까요? 우리는 확률을 정확하게 알 수 없습니다. 그럼에도 불구하고 확률을 가지고 어떠한 metric을 구성하게 된다면, 더이상 직관적으로 해석할 수 있는 방법은 사라지게 되고, 더 높은 수준의 지식을 요구하게 됩니다. 이번 포스팅에서 자세하게 소개하지는 않았으나, 언젠가 기회가 된다면 소개드릴 다음 두가지 metric이 probability를 통해 계산하는 metric입니다.
- Log-loss
- ROC Curve & AUC
Log-loss는 확률론 및 통계학에서 주로 다루는 Bernoulli Likelihood를 의미합니다. 또한, ROC Curve와 AUC는 threshold를 설정하기에 굉장히 용이한 방법론이기도 합니다. 이 외에도 다양한 metric이 어디선가 만들어지고 있을 수 있습니다. 이러한 방대한 성능 평가 metric에 관심이 있으시다면 다른 분들의 포스팅을 참고해서 보시는 것도 좋을 듯 합니다.
Leave a comment